Die Qualität medizinischer KI lässt sich nicht allein daran messen, wie intelligent ein Sprachmodell wirkt. Entscheidend ist, ob sich seine Aussagen nachvollziehen, überprüfen und gegebenenfalls widerlegen lassen. Die SEIG-Loop macht’s möglich.
Large Language Models (LLMs) sind in der medizinischen Versorgung längst angekommen. Sie formulieren Arztbriefe, fassen komplexe Patientenakten zusammen, erstellen Informationsmaterialien oder unterstützen bei Literaturrecherchen. Gerade in der Psychiatrie zeigt sich jedoch besonders deutlich, wo die Grenzen dieser Systeme liegen: Sprachlich überzeugende Antworten sind nicht automatisch klinisch korrekt.
Darauf weisen Martin P. Paulus und John Torous in einem aktuellen Viewpoint in JAMA Psychiatry hin. LLMs können Informationen erfinden, relevante Details auslassen oder widersprüchliche Befunde zu einer scheinbar schlüssigen Geschichte zusammenfügen. Die Autoren plädieren deshalb dafür, KI nicht als autonomen klinischen Akteur, sondern als klinisches Instrument zu verstehen. Die Verantwortung für Diagnostik und Therapie bleibt beim qualifizierten Behandler.
Vier Schritte für einen sichereren Umgang mit LLMs
Als praktisches Konzept schlagen Paulus und Torous den sogenannten SEIG-Loop vor. Das Akronym steht für Specify – Elicit – Interrogate – Ground.
- Specify – Aufgabe präzisieren:
Vor jeder Anfrage sollte festgelegt werden, welche Aufgabe die KI übernehmen soll, für wen die Antwort bestimmt ist, welche Quellen verwendet werden dürfen und welche Entscheidungen ausdrücklich nicht delegiert werden. - Elicit – strukturierte Antworten verlangen:
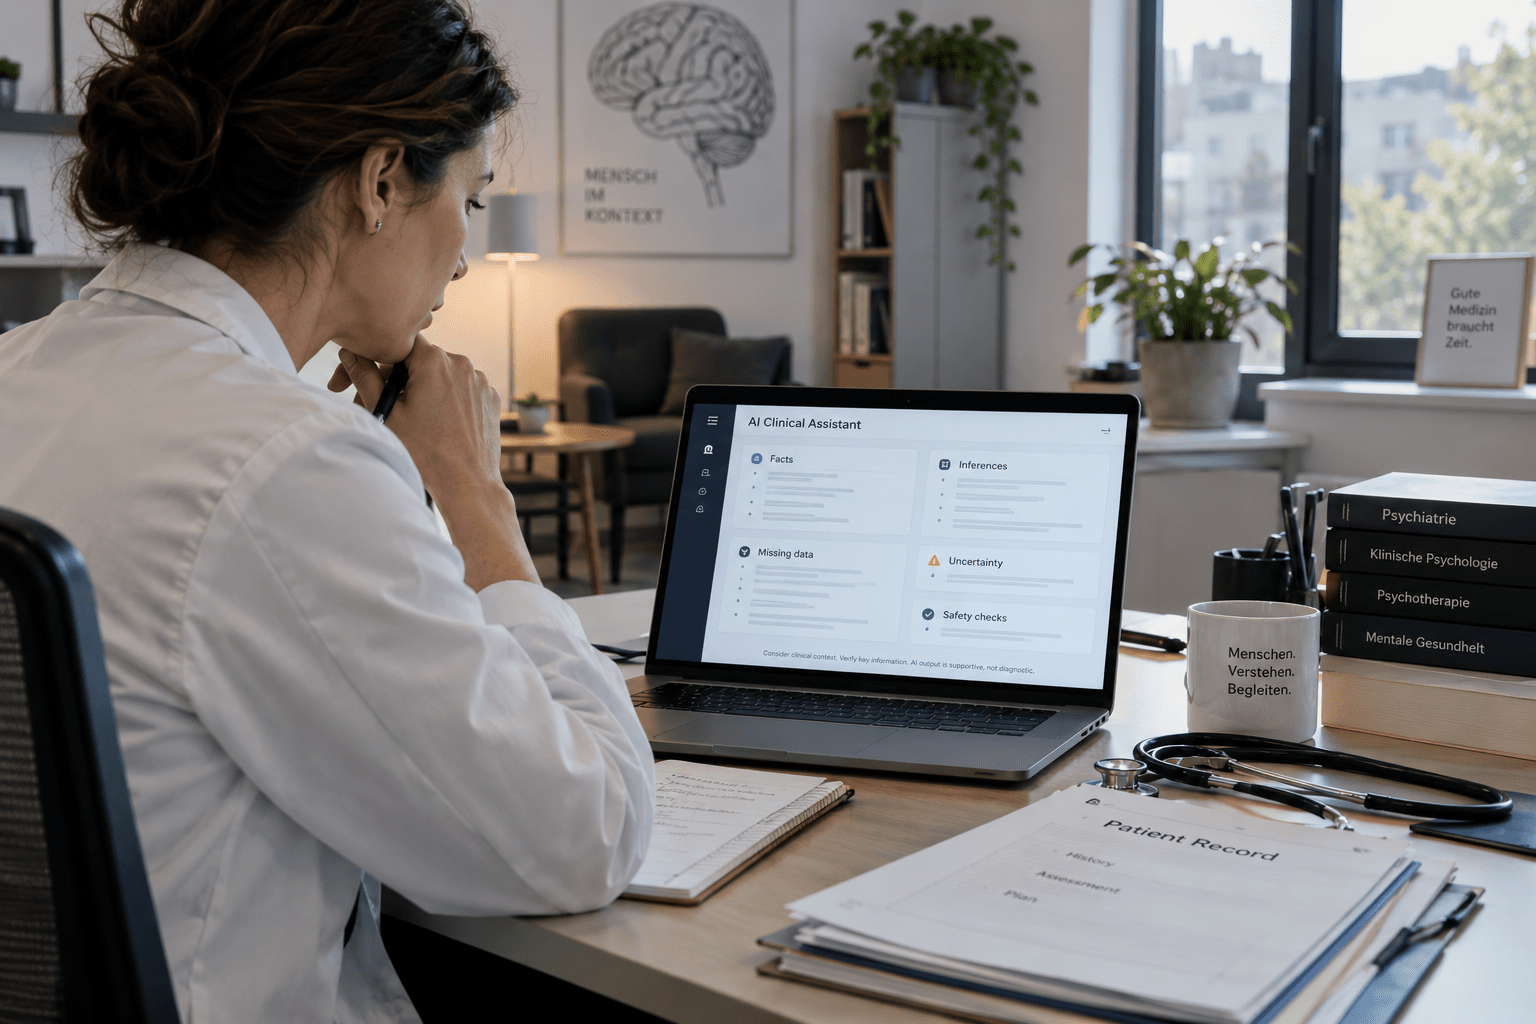
Das Modell sollte Fakten, Schlussfolgerungen, fehlende Informationen und Unsicherheiten klar voneinander trennen. Gerade diese Differenzierung kann verhindern, dass Vermutungen unbemerkt als gesicherte Tatsachen übernommen werden. - Interrogate – die erste Antwort hinterfragen:
Statt das initiale Ergebnis einfach zu akzeptieren, sollte die KI gezielt nach alternativen Erklärungen, möglichen Verzerrungen und Gegenargumenten gefragt werden: Welche Befunde sprechen gegen die vorgeschlagene Interpretation? Welche zusätzlichen Informationen könnten die Einschätzung verändern? - Ground – Aussagen an Quellen rückbinden:
Faktische Aussagen müssen auf konkrete Quellen zurückgeführt werden – beispielsweise Befundberichte, Untersuchungszeitpunkte, Scores oder Medikationsdaten. Fehlt ein Beleg, sollte dies ausdrücklich gekennzeichnet werden. Damit verändert sich die Rolle des LLM: vom vermeintlichen „Antwortgenerator“ zum kontrollierten Hypothesengenerator.
Entscheidend ist nach Ansicht der Autoren die Qualität der Interaktion zwischen Arzt und System: Wurden Fakten und Interpretation getrennt? Wurden fehlende Informationen erkannt? Ist die Unsicherheit sichtbar? Und wurde erkannt, wann eine Entscheidung nicht an eine KI delegiert werden darf?
Aussagen wie „unzureichende Evidenz in der Akte“, „direkte erneute Untersuchung erforderlich“ oder „das Modell sollte für diese Entscheidung nicht eingesetzt werden“ sind in diesem Verständnis Zeichen eines kompetenten Umgangs mit KI.
Klinische Verantwortung bleibt undelegierbar
Besonders klare Grenzen ziehen Paulus und Torous bei Entscheidungen mit unmittelbaren Konsequenzen für Patientinnen und Patienten. Diagnostische Gesamtbewertung, Einschätzung des Suizidrisikos, Änderungen einer Medikation oder Entscheidungen über unfreiwillige Behandlungen müssen in der Verantwortung qualifizierter Ärztinnen und Ärzte bleiben. KI kann Informationen strukturieren, Optionen vorbereiten und auf offene Fragen hinweisen – sie ersetzt jedoch keine klinische Verantwortlichkeit.
Gleichzeitig genügt es nicht, die Verantwortung allein beim einzelnen Anwender abzuladen. Gesundheitseinrichtungen benötigen validierte Anwendungsfälle, freigegebene Templates, Versionskontrollen, Auditmöglichkeiten und systematische Verfahren zum Umgang mit Fehlern, Halluzinationen, Auslassungen und Bias. Für die klinische Praxis könnte genau diese Haltung entscheidend werden: Nicht der perfekte Prompt macht KI sicher – sondern ein Arbeitsprozess, der Fehler sichtbar macht, bevor sie die Patientenversorgung beeinflussen.
Text: Reinhard Merz
Bild: openAI für arztCME
Quelle:
Paulus MP, Torous J. LLMs as Clinical Instruments—Toward Verifiable Reasoning. JAMA Psychiatry 2026. doi:10.1001/jamapsychiatry.2026.2211.